כרטיס NVIDIA עם 12GB זיכרון יכול להיות חלק ממחשב שמריץ מודל מקומי גדול. הוא אינו כל המחשב הדרוש. Strata משתמש גם במעבד ובזיכרון המערכת. ב-Mac, גיזום REAP והעברת טבלת n-gram ל-SSD ב-oMLX מפחיתים רכיבים שונים של דרישת הזיכרון.
בדקנו את מסמכי המקור ב-13 באוקטובר 2026. לא הרצנו את המודלים לצורך המאמר. נתוני הביצועים בהמשך הם מדידות שפרסמו מחברי הפרויקטים.
מה דרוש ל-Strata בכרטיס RTX מסדרה 20 ומעלה?
פרויקט Strata מציין כרטיסי NVIDIA RTX מסדרות 20, 30, 40 ו-50 עם 12GB VRAM ומעלה כמסלול הרגיל. שם הסדרה אינו מספיק: לא לכל כרטיס בסדרות האלה יש נפח זיכרון כזה.
הדרישות כוללות גם Windows 10/11 או Linux, מנהל התקן NVIDIA מגרסה 580 ומעלה וזיכרון מערכת שמתאים למודל הנבחר. גרסת Coder היא נקודת הפתיחה הקטנה ביותר ברשימה, למחשב עם 32GB RAM. גרסאות אחרות דורשות יותר זיכרון. אלו דרישות למודלים המתועדים בפרויקט, ולא הבטחה לתמיכה בכל מודל.
מדריך ההתקנה מציין 70–80GB למודל ועוד כ-6GB לשכבת MTP. קובצי תמונה מוסיפים כ-1GB. גרסת Q2_0 במעבד AVX-512 יכולה לכתוב עותק נוסף של כ-40GB. השאירו מקום גם לקבצים האלה ולתוכנה. המדריך מציין שגם GPU עם 8GB יכול לפעול לאט; המאמר מתמקד במסלול הרגיל של 12GB.
מדריך בחירת המודל מפרט את האפשרויות:
| זיכרון מערכת | נקודת פתיחה | מגבלה עיקרית |
|---|---|---|
| 32GB | Coder | הגיזום מכוון לקוד; יש לבדוק משימות אחרות |
| 48GB | IQ2_XS או Q2_0 | משקולות בכימות קטן יותר |
| 64GB | IQ2_XS, IQ3_XXS או IQ3_S | יותר אפשרויות, עם הבדלי מהירות ואיכות |
לפני רכישה, בדקו את הדגם המדויק, נפח VRAM, זיכרון RAM פנוי, המעבד, ה-SSD ופורמט המודל. אם המחשב כבר ברשותכם, בדקו את המשימות שלכם לפני שדרוג חומרה.
כיצד Strata מריץ מודל גדול עם VRAM מוגבל?
Strata משתמש במודל תערובת מומחים. נתב בוחר מספר קטן של רשתות מומחים לכל טוקן. כל המומחים עדיין צריכים מקום אחסון, גם כאשר רק חלקם פעילים.
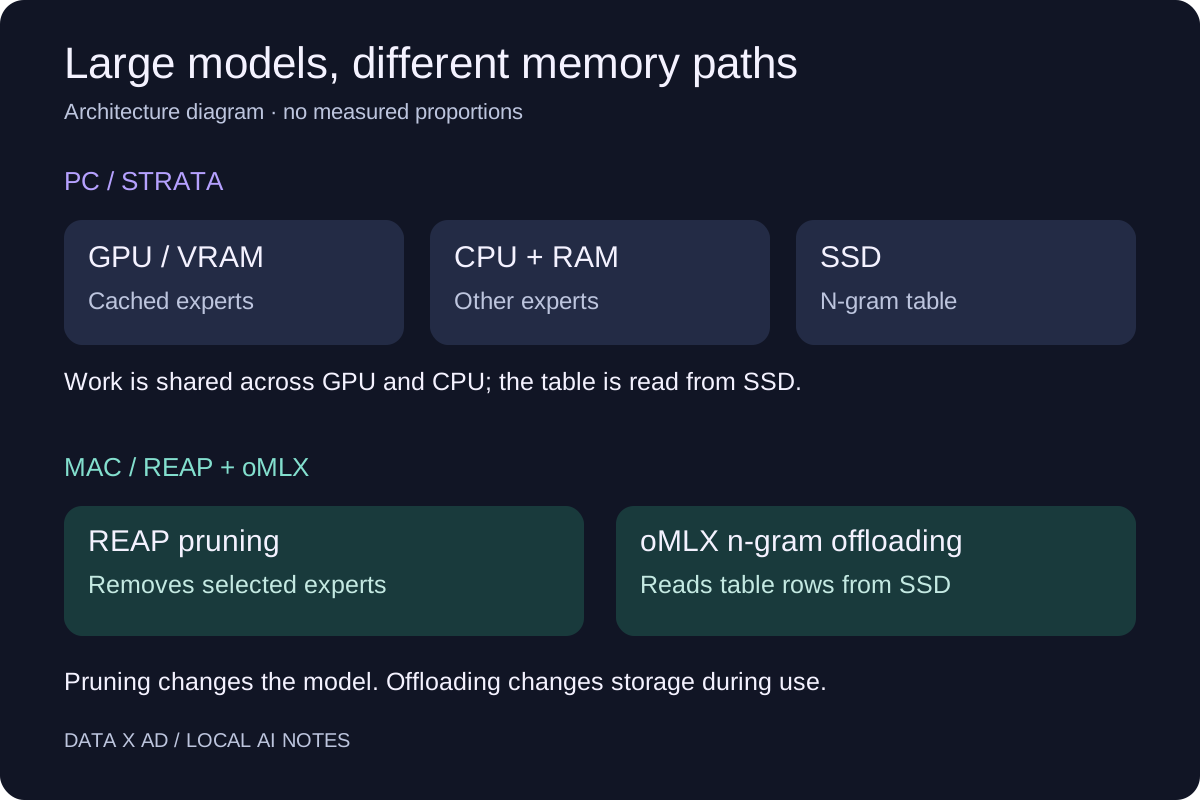
לפי מדריך הארכיטקטורה, מומחים שנדרשים לעיתים קרובות נשארים במטמון ב-GPU. זיכרון המערכת מחזיק את המומחים, והמעבד מחשב מומחים שאינם במטמון. המעבד וה-GPU יכולים לעבוד במקביל. טבלת n-gram נפרדת נשמרת ב-SSD; לכל טוקן נדרשות רק מספר שורות ממנה.
לכן אין צורך להחזיק את כל משקולות המודל ב-VRAM. עם זאת, מעבד איטי או מחסור ב-RAM עדיין יכולים להגביל את הביצועים. ה-SSD אינו תחליף לכל זיכרון העבודה.
אילו ביצועים מחבר Strata מדד?
מסמך המדידות מתאר RTX 5070 עם 12GB VRAM, מעבד Ryzen 5 7600 ו-64GB DDR5. בגרסת מנוע 0.1.26, המחבר מדווח על כ-79 טוקנים לשנייה ב-IQ2_XS וכ-53 ב-IQ3_S, עם הקשר של 4K.
אלו תוצאות של תצורה אחת. הן אינן מדידה של RTX 2060 או של Mac. עיבוד הקלט, יצירת התשובה ועבודה עם הקשר ארוך הם עומסים שונים. קצב יצירת טקסט גבוה יכול להגיע אחרי המתנה ארוכה לטוקן הראשון.
בכל השוואה, רשמו גרסת מנוע, כימות, אורך הקשר וחומרה. השתמשו באותו קלט ובאותה מגבלת פלט. נתון שיא בודד אינו מתאר יום עבודה בתכנות.
מה REAP משנה במודל MLX?
REAP הוא קיצור של Router-weighted Expert Activation Pruning. השיטה משתמשת במשקלי הנתב ובפעילות המומחים כדי לבחור אילו מומחים להסיר. כך נפח המודל קטן, אך גם איכות התשובות יכולה להשתנות. כימות הוא שינוי נפרד, שמפחית את הדיוק שבו נשמרות המשקולות.
המרת MLX מתאימה את פורמט המודל למסגרת MLX של Apple. השם REAP אינו מבטיח שתוכנת הריצה תומכת בארכיטקטורה. יש לבדוק יחד את כרטיס המודל ואת גרסת התוכנה.
דוגמה היא Qwen3.8-Flash-Next-REAP-288-MLX-4bit. המחבר משאיר 288 מתוך 512 מומחים בכל שכבת MoE. הוא מדווח על כ-68GB בדיסק וכ-68GB בזיכרון כאשר הטבלה נמצאת בזיכרון. עם הזרמת n-gram ב-oMLX, הוא מדווח על כ-39GB בזיכרון. אלו מדידות המחבר, לא בדיקות של Dataxad.
כיצד פועלת העברת n-gram ל-SSD ב-oMLX?
טבלת n-gram היא טבלת חיפוש גדולה של וקטורי הטמעה. קריאת השורות הדרושות מה-SSD מפחיתה זיכרון תושב בלי למחוק את השורות מהמודל. הפעולה נפרדת מגיזום מומחים וממטמון KV, ששומר את מצב הקשב של ההקשר הנוכחי.
קוד ניהול הזיכרון של oMLX בודק תמיכה במסלול הזה. הוא משווה את אומדן הזיכרון המלא לתקרה שנקבעה. הוא בוחר ב-SSD כאשר האומדן המלא חורג מהתקרה, אך האומדן המופחת מתאים לה.
תקרה נמוכה יותר יכולה לבחור מסלול אחסון אחר. היא אינה מוסיפה תמיכה למודל לא תואם ואינה מבטיחה התאמה לכל אורך הקשר או מספר בקשות במקביל. צריך להשאיר זיכרון ל-macOS, ליישומים ולמצב הריצה.
איך מפעילים את המודל עם oMLX?
כרטיס המודל מתעד oMLX מגרסה v0.6.4 ומעלה. הערות הגרסה מאשרות תמיכה ב-Qwen3.8 ותיקוני PLE. הפקודות הבאות מבוססות על דוגמת ההתקנה בכרטיס המודל; לא ביצענו התקנה זו עבור המאמר.
- התקינו את oMLX דרך מקור Homebrew המתועד.
brew install jundot/omlx/omlx- הורידו את המודל באמצעות כלי Hugging Face CLI מותקן.
hf download sh0wie/Qwen3.8-Flash-Next-REAP-288-MLX-4bit \
--local-dir ~/models/Qwen3.8-Flash-Next-REAP-288-MLX-4bit- הפעילו את השרת עם תקרת הזיכרון שבדוגמה.
omlx serve --model-dir ~/models --memory-guard-gb 48קוד ה-CLI מגדיר את --memory-guard-gb כתקרה מותאמת ב-GB. המספר 48 הוא הגדרת שרת. הוא אינו המלצה שנבדקה ל-Mac עם 48GB זיכרון. התחילו בבקשה אחת וקלט קצר, ובדקו לחץ זיכרון לפני הגדלת ההקשר.
האם מצב 39GB נותן גם 65 טוקנים לשנייה?
כרטיס המודל אינו מספק מדידת oMLX שתומכת בטענה הזו. הטבלה בו משייכת כ-28 טוקנים לשנייה ל-mlx-vlm רגיל. הנתונים של 37–65 טוקנים לשנייה שייכים למנוע pmlx נפרד. המחבר מציין במפורש שלא נמדד קצב oMLX בנפרד.
המחבר מדווח גם על ריצת HumanEval אחת ומציין שהכיול מכוון למשימות קוד. משקולות הראייה נשארו במודל, אך איכות הראייה לאחר הגיזום לא נבדקה. בדקו את השפה, קריאות הכלים והמסמכים שלכם.
איך משווים את האפשרויות בפועל?
הכינו מערך קטן של משימות אמיתיות: שאלה קצרה, משימת מסמך ושינוי קוד שאפשר לבדוק. שמרו על אותם קלטים בכל תצורה.
רשמו את גרסת המודל והתוכנה, הכימות, החומרה, אורך הקלט והפלט, הזמן לטוקן הראשון, קצב היצירה, שיא הזיכרון והתקלות. בדקו גם את נכונות התשובות. חזרו על כל בדיקה והפרידו בין הפעלה ראשונה לבין בקשות שמשתמשות במטמון.
לבעלי GPU עם 8GB, המדריך באנגלית למודלים מקומיים ב-8GB מציע נקודת פתיחה קטנה יותר. צוותים שמשווים חומרה מקומית לשירות מתארח יכולים לפנות ל-Dataxad כדי להגדיר בדיקה שמתאימה לעבודה לפני רכישה.